
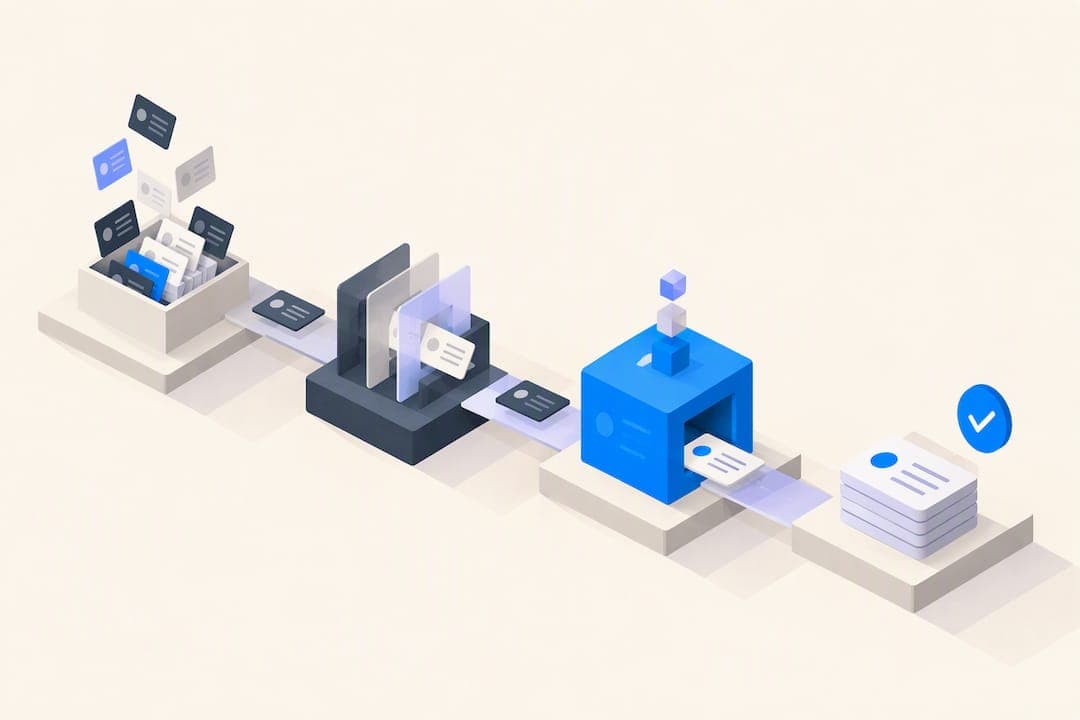
Un pipeline d'analyse est un ensemble de processus automatisés qui déplacent, nettoient et stockent des données brutes pour les rendre exploitables. Il se construit en quatre étapes : ingestion, transformation, stockage, consommation, que ce soit pour un tableau de bord, un modèle de machine learning ou un rapport métier. Sa valeur dépend autant de sa rigueur technique que de sa conformité au RGPD.
En bref:
- Choisissez les lots pour les rapports périodiques, le flux continu pour détecter la fraude ou déclencher des alertes, et l’hybride pour limiter les coûts.
- L’ETL impose de transformer les données avant leur chargement, tandis que l’ELT les charge brutes et facilite les itérations des analystes dans l’entrepôt.
- Contrôlez chaque flux selon son schéma, testez les transformations sur des données de référence et configurez des alertes sur le débit, la latence et les erreurs.
- Une AIPD n’est obligatoire que si le traitement présente un risque élevé ; minimisez alors les données collectées et chiffrez-les en transit comme au repos.
- Avant d’internaliser, testez un seul cas d’usage pendant quelques semaines et vérifiez que l’équipe peut maintenir la chaîne sans aide externe récurrente.
Table des matières
- Les étapes détaillées d'un pipeline d'analyse
- Batch, streaming, hybride : quelle architecture choisir
- Les briques techniques qui composent un pipeline moderne
- Qualité des données, monitoring et fiabilité des traitements
- RGPD, AIPD et sécurité des données dans un pipeline
- Cas d'usage concrets et chiffres sur l'analyse de données en France
- Perspective Domain Alpha : évaluer la qualité des signaux .fr
- Internaliser ou externaliser la construction de son pipeline
- Comment Domain Alpha vous aide à exploiter les signaux .fr
- Questions fréquentes
- Sources
Les étapes détaillées d'un pipeline d'analyse
Un pipeline de données est une série de processus automatisés qui déplacent, transforment, filtrent, reformatent et stockent des données brutes vers une destination où elles deviennent exploitables. Chaque étape répond à un besoin précis, et les mélanger produit des résultats difficiles à corriger plus tard.
- Ingestion : les données arrivent depuis des API, des webhooks, des fichiers déposés en batch ou des capteurs IoT. Le choix du connecteur dépend de la fraîcheur recherchée : un flux transactionnel justifie un webhook, un export comptable mensuel se contente d'un fichier plat.
- Transformation : cette étape nettoie les doublons, normalise les formats de dates ou de devises, enrichit les enregistrements avec des référentiels externes et permet une première exploration statistique (EDA) pour repérer les anomalies.
- Stockage : selon l'usage visé, les données atterrissent dans un data lake pour des formats bruts et hétérogènes, un entrepôt de données structuré pour l'analyse décisionnelle, ou un magasin de caractéristiques dédié aux modèles de machine learning.
- Consommation : la dernière étape alimente des tableaux de bord, des rapports automatisés, des pipelines de machine learning ou de simples exports vers d'autres systèmes métier.
Les ressources techniques qui décrivent ces étapes classiques d'un pipeline de données rappellent que l'ingestion, la transformation et le stockage forment le socle commun, quelle que soit l'architecture retenue ensuite. Préparer un pipeline pour le machine learning exige en plus une gestion des magasins de caractéristiques, un versioning des jeux de données et la capacité à rejouer des traitements passés pour garantir la reproductibilité des résultats.
Pour un investisseur qui suit un tableau de bord de portefeuille de domaines, cette chaîne se traduit concrètement : les nouveaux enregistrements .fr sont ingérés quotidiennement, nettoyés, scorés, puis affichés sous forme d'indicateurs lisibles.
Batch, streaming, hybride : quelle architecture choisir
Le choix entre les modèles d'architecture dépend surtout de la fraîcheur des données dont vous avez besoin et du volume à traiter. Un pipeline mal dimensionné sur ce point coûte cher à corriger après coup.
- Batch : les données sont traitées par lots, à intervalle régulier (toutes les heures, chaque nuit). Ce modèle convient aux rapports financiers mensuels ou aux synchronisations de catalogues produits.
- Streaming : les événements sont traités au fil de l'eau, en quelques secondes. Il s'impose pour la détection de fraude, le suivi de trafic web en direct ou les alertes opérationnelles.
- Hybride : certains flux critiques passent en streaming tandis que les agrégations lourdes restent en batch nocturne, un compromis courant pour limiter les coûts d'infrastructure tout en gardant une réactivité ciblée.
- ETL (extraction, transformation, chargement) : la transformation a lieu avant le chargement, ce qui convient aux entrepôts traditionnels où la structure doit être figée à l'arrivée.
- ELT (extraction, chargement, transformation) : les données brutes sont chargées telles quelles, puis transformées directement dans l'entrepôt grâce à la puissance de calcul moderne, une approche de plus en plus répandue avec les plateformes cloud.
Le choix entre ETL et ELT dépend aussi de votre équipe : l'ETL demande une planification en amont plus poussée, tandis que l'ELT facilite les itérations rapides pour des analystes qui écrivent directement leurs transformations en SQL.
Les briques techniques qui composent un pipeline moderne
Derrière chaque pipeline fonctionnel se cachent plusieurs familles d'outils, chacune responsable d'une tâche précise. Les connaître aide à poser les bonnes questions avant de choisir une solution.
- Orchestrateurs : ces moteurs de workflow planifient l'exécution des tâches, gèrent les dépendances entre elles et relancent automatiquement un job qui a échoué.
- Systèmes de messagerie et de streaming : ils absorbent des flux continus d'événements et les distribuent vers plusieurs consommateurs sans perte de données.
- Moteurs de transformation SQL : ils permettent d'écrire la logique de nettoyage et d'agrégation directement dans l'entrepôt, en s'appuyant sur des formats de stockage optimisés comme Parquet ou Avro pour accélérer la lecture.
- Stockage découplé : séparer le calcul du stockage permet de faire grossir l'un sans toucher à l'autre, un principe désormais standard sur les plateformes cloud.
- Magasins de caractéristiques : dédiés au machine learning, ils centralisent les variables prêtes à l'emploi pour éviter de recalculer les mêmes transformations à chaque entraînement de modèle.
Conseil de pro : avant d'ajouter un nouvel outil à votre pipeline, vérifiez qu'il résout un problème que vos briques existantes ne couvrent pas déjà, l'empilement d'outils redondants est la première cause de coûts de maintenance qui explosent.
Qualité des données, monitoring et fiabilité des traitements
Un pipeline qui tourne sans supervision finit toujours par produire des chiffres faux sans que personne ne s'en aperçoive à temps. Quatre réflexes limitent ce risque.
- Validation de schéma : chaque flux entrant est vérifié contre une structure attendue, ce qui permet de détecter une dérive de schéma avant qu'elle ne casse un tableau de bord en aval.
- Tests de régression : les transformations critiques sont testées sur des jeux de données de référence pour s'assurer qu'une modification du code ne change pas silencieusement les résultats.
- Observabilité : logs, métriques de débit, latence et taux d'erreur doivent être centralisés avec des alertes configurées sur les seuils critiques.
- Idempotence et gestion des identifiants : un job relancé après un échec doit produire exactement le même résultat, jamais des doublons, ce qui suppose des identifiants uniques et des mécanismes de déduplication.
Le guide sur l'investigation métier rappelle un principe simple mais souvent négligé : la qualité et la disponibilité des données doivent être validées avant toute implémentation, car un pipeline bâti sur des données non fiables ne fait qu'amplifier le problème en aval.
RGPD, AIPD et sécurité des données dans un pipeline
Dès qu'un pipeline traite des données personnelles, la conformité RGPD s'impose dès la conception, pas après coup.
- Analyse d'impact (AIPD/PIA) : l'article 35 du RGPD impose une analyse d'impact lorsque le traitement présente un risque élevé pour les personnes concernées, avec des livrables qui documentent les risques et les mesures correctives.
- Minimisation et anonymisation : ne collecter que les champs réellement nécessaires, pseudonymiser ou anonymiser dès que possible, et fixer des durées de conservation proportionnées à la finalité.
- Chiffrement : les données doivent être protégées en transit comme au repos, avec une gestion fine des accès et une traçabilité des consultations.
- Documentation continue : chaque modification du pipeline qui touche aux données personnelles doit être reflétée dans le registre des traitements.
La méthode PIA publiée par la CNIL détaille précisément comment mener cette analyse d'impact relative à la protection des données, étape par étape, pour documenter les risques et mesurer la proportionnalité d'un traitement dès la phase de conception du pipeline.
Cas d'usage concrets et chiffres sur l'analyse de données en France
En France, les pipelines d'analyse servent surtout à exploiter des données clientèle, des données issues de l'open data ou des capteurs IoT industriels.
- Tableaux de bord décisionnels : suivi des ventes, du trafic web ou des indicateurs RH en temps quasi réel.
- Scoring et détection : évaluation de risque client, détection de fraude ou de comportements atypiques.
- Maintenance prédictive : anticipation des pannes à partir de capteurs IoT installés sur des lignes de production.
Les statistiques publiées par l'INSEE détaillent la répartition des pratiques d'analyse des entreprises françaises, en distinguant celles qui traitent les données en interne de celles qui passent par un prestataire externe, un repère utile pour situer sa propre organisation.
Perspective Domain Alpha : évaluer la qualité des signaux .fr
Notre approche s'appuie sur une méthode entièrement déterministe, sans intelligence artificielle générative : chaque nouveau nom de domaine .fr est passé au crible d'une analyse lexicale qui mesure la clarté sémantique et le potentiel commercial. Ce choix répond au même principe qui guide tout pipeline d'analyse sérieux : la fiabilité d'un résultat dépend de la rigueur du traitement qui l'a produit, jamais de sa seule rapidité.
Nous appliquons ce filtre chaque jour à l'ensemble des créations de domaines .fr, ce qui revient à faire tourner un pipeline de transformation et de scoring en continu. Notre méthode d'analyse des nouveaux noms de domaine .fr détaille comment ce tri lexical sépare les signaux exploitables du bruit, un travail de filtrage comparable à celui qu'exige tout pipeline de qualité.

Internaliser ou externaliser la construction de son pipeline
Le choix dépend de quatre critères : l'expertise technique déjà disponible en interne, le volume et la fréquence des données à traiter, la sensibilité RGPD des flux concernés, et le budget alloué. Un pilote limité à un seul cas d'usage, mesuré sur quelques semaines, permet de juger si l'internalisation tient la charge avant d'investir davantage. Le signal de succès le plus clair reste la capacité de l'équipe à maintenir le pipeline sans intervention externe récurrente.
— Kevin
Comment Domain Alpha vous aide à exploiter les signaux .fr
Repérer les domaines .fr à fort potentiel commercial demande le même travail qu'un pipeline d'analyse classique : trier le bruit, scorer ce qui reste, documenter chaque décision. Nous le faisons à votre place, chaque jour, avec une méthode déterministe et transparente plutôt qu'une boîte noire.
- Un classement quotidien des nouveaux domaines .fr, avec score lexical et justification textuelle pour chacun.
- Une recherche libre pour évaluer un nom précis selon les mêmes critères.
- Un essai gratuit de 7 jours pour juger la pertinence du scoring avant de vous engager.
Pour accéder au classement quotidien et à la recherche libre, l'abonnement mensuel est proposé à un tarif accessible avec un engagement annuel avantageux.
Questions fréquentes
C'est quoi un pipeline de données concrètement ?
Un pipeline de données est une chaîne automatisée qui déplace, nettoie et stocke des données brutes pour les rendre exploitables par des analystes ou des modèles. Il comprend généralement quatre étapes : ingestion, transformation, stockage et consommation.
Comment traduire pipeline en français de façon naturelle ?
Dans le contexte de la donnée, on parle couramment de « chaîne de traitement de données » ou de « flux de traitement », l'anglicisme « pipeline » restant toutefois l'usage le plus répandu dans les équipes techniques françaises. Les deux formulations désignent la même réalité technique.
Qu'est-ce que le pipeline logiciel par opposition au pipeline de données ?
Le pipeline logiciel, ou pipeline d'intégration continue, désigne la chaîne automatisée qui compile, teste et déploie du code applicatif. Le pipeline de données, lui, déplace et transforme des informations plutôt que du code, même si les deux s'appuient sur des principes d'orchestration similaires.
Faut-il une analyse d'impact pour tout pipeline traitant des données personnelles ?
Non, une analyse d'impact (AIPD) n'est obligatoire que lorsque le traitement présente un risque élevé pour les personnes concernées, selon l'article 35 du RGPD. La méthode publiée par la CNIL aide à déterminer si votre cas l'exige et comment la documenter.
Combien coûte un service d'analyse de domaines .fr comme Domain Alpha ?
Pour connaître les tarifs actuels et les modalités d'essai du service, veuillez consulter la page de tarification sur le site officiel.